第 3 回 ペア探索の実践
ペアトレードの数理と実践
前回では、ペアトレードの土台となる「スプレッドの弱定常性」と「平均回帰(Mean Reversion)」の数理メカニズムについて解説しました。移動平均型モデルやWoldの分解定理を通じ、「過去のショックが時間の経過とともに減衰し、一定の平均値 \(\mu\) に回帰する」という動態を数式で確認しました。
では、私たちは具体的にどのような方法によって「平均回帰するスプレッド」を市場から見つけ出せばよいのでしょうか?
今回のテーマは、「非定常な世界から、定常なスプレッドを統計的に抽出する数理」です。単に「相関係数が高いから」という直感的な理由でペアを選ぶと、なぜ危険な結末(見せかけの回帰)を迎えるのか。そして、それを回避するための「共和分(Cointegration)」の概念と検定手法について解説します。
1. 非定常から定常を生み出す「共和分」のロジック
1.1. 単体の資産価格はなぜ厄介か?
まず、個々の株価の性質を数理的に定義しておきましょう。ある資産 \(A\) の時刻 \(t\) における価格を \(A_t\)
とします。多くの場合、株価の効率的市場仮説に基づき、価格は次のようなランダムウォークに従うと仮定されます。
\[A_t = A_{t-1} + \varepsilon_t^A\]
ここで \(\varepsilon_t^A\) はホワイトノイズであるとします。すなわち、\(\varepsilon_t^A\) は平均値がゼロで分散が定数 \(\sigma^2\) 、自己共分散 \(\hspace{0.2em} Cov(X _ t,X _{t-h}\hspace{0.2em})\) がラグ 1 以上ですべてゼロである定常時系列です。
\(A_t\) を過去に遡って展開すると以下のように表せます。
\[A_t = A_0 + \sum_{i=1}^{t} \varepsilon_i^A\]
この式からわかる通り、時刻 \(t\) における価格 \(A_t\) の分散は \(t \; \sigma^2\) となり、時間が経つにつれて分散が無限大に拡散していきます。つまり、過去のショック \(\varepsilon_i^A\) が一切減衰せずに累積し続けるため、平均も分散も一定になりません。しかし一回差分は定常時系列になっている。このような性質を持つ確率過程を「1 次和分過程」と呼び、\(I(1)\) と表記します。
「見せかけの回帰(Spurious Regression)」の恐怖
投資実践の場面で気を付けなければならないのは、2つの非定常な銘柄 \(A_t \sim I(1)\) と \(B_t \sim I(1)\) の間で単純に最小二乗法(OLS)による回帰分析を行ったり、相関係数を計算したりすることです。
もし、2つの銘柄がまったく無関係に動いていたとしても、トレンド(累積したショックの方向性)がたまたま一致しているだけで、統計的には「非常に強い相関がある(決定係数 \(R^2\) が 1 に近い)」という結果が弾き出されてしまいます。この相関を信じてスプレッドを組むと、スプレッドは二度と元の平均に戻らず、大きく乖離して想定外の損失を被る可能性があります。ペアトレーディングでは信用取引を活用しショートポジション(売り)を入れていきますので損失は原理的に青天井になり得ます。
1.2. 共和分(Cointegration)の定義
見せかけの回帰を回避し、数学的に「必ず平均回帰する」ことが裏付けられたペアを定義するのが共和分の概念です。
【共和分の定義】 ともに \(I(1)\)(非定常)である2つの時系列 \(A_t\) と \(B_t\) が存在するとき、ある定数 \(\beta\) (係数)が存在し、それらの線形結合として定義されるスプレッド \(S_t\) \[S_t = A_t – \beta B_t\] が \(I(0)\)(定常過程) になるとき、時系列 \(A_t\) と \(B_t\) は共和分関係(Cointegrated)にあると言う。
前回スプレッドの構成法でコメントしましたが、本稿ではコードの実装を生株価ではなく対数株価で処理しています。 \(A_t = \log(P_A^t)\)、\(B_t = \log(P_B^t)\) 。対数株価は生株価と同様に \(I(1)\) であるため定義の前提を満たします。さらに対数変換により β が価格水準に依存しない弾力性(B が 1% 変化したとき A が何% 変化するか)として解釈できるようになり、異なる価格水準の銘柄間でも安定したヘッジ比率推定が可能になります。
右辺の \(A_t\) も \(B_t\) も、単体ではどこに飛んでいくかわからない非定常時系列です。しかし、適切な比率 \(\beta\) でポートフォリオ(ロングとショート)を組むと、両者が持つ「無限に拡散するショック(ランダムウォークの成分)」が綺麗に相殺され、残った誤差項 \(S_t\) は狭い一定の範囲に束縛される(定常になる)のです。
経済学的には、2つの資産の間に「長期的な均衡関係」が存在している状態を指します。一時的に \(S_t\) が平均から離れても、市場の裁定インセンティブなどが働き、いずれ \(S_t\) は元の水準へと引き戻されます。
1.3. ペアを検定する2つのアプローチ
市場に存在する数千の銘柄から共和分関係にあるペアを厳密に見つけるため、良く知られた2つの統計的検定アプローチを紹介しましょう。
① エングル・グレンジャー(Engle-Granger)検定
直感的かつシンプルな仕組みの良く知られた手法です。
第1段階(OLS回帰による \(\beta\) 推定): まず、\(A_t = \beta B_t + \alpha + e_t\) として最小二乗法で回帰分析を行い、係数 \(\beta\) と残差系列 \ \hat{e}_t\) を求めます。
第2段階(単位根テスト): 得られた残差系列 \(\hat{e}_t\) に対して、ADF(拡張ディッキー・フラー)検定を行い、「単位根が存在する(非定常である)」という帰無仮説を棄却できるか調べます。もし棄却できれば、残差は \(I(0)\) であり、共和分が成立していると判定します。
② ヨハンセン(Johansen)検定
エングル・グレンジャー法は「サンプル数が十分大きくない場合、どちらの銘柄を目的変数(左辺)にするか」によって残差の検定結果が変わり得る恣意性の問題が指摘されています。
ヨハンセン検定はベクトル値自己回帰モデル(Vector Autoregressive Model,VAR)モデルをベースにしています。この手法では複数の銘柄(3つ以上のマルチペアへの拡張も可能)の相互関係を対等に扱うことができます。そして行列の階数(ランク)を調べることで、システム内に「いくつの共和分ベクトルが存在するか」をトレース統計量や最大固有値統計量を用いて検定することができます。この手法により前述の恣意性の問題を克服しています。
また、この検定手法では、共和分関係が確認されたペアは、単に「いつか戻る」だけでなく、「どれくらいの速度で戻るか」を数理的にモデル化したベクトル誤差修正モデル(VECM: Vector Error Correction Model)を採用しています。
ベクトルの成分が2つの資産から構成される \(Y_t = (A_t,B_t)\) とします。資産の価格変化率(差分)を、直前のスプレッドの乖離度(誤差)を使って以下のように表現します。
\[\Delta A_t = \gamma_A (A_{t-1} – \beta B_{t-1} – \alpha) + \sum \phi_{A, i} \Delta A_{t-i} + \sum \psi_{A, i} \Delta B_{t-i} + \varepsilon_{A, t}\]
\[\Delta B_t = \gamma_B (A_{t-1} – \beta B_{t-1} – \alpha) + \sum \phi_{B, i} \Delta A_{t-i} + \sum \psi_{B, i} \Delta B_{t-i} + \varepsilon_{B, t}\]
ここで最も重要なパラメータが、誤差修正係数(速度パラメータ) \(\gamma_A, \gamma_B\) です。 例えば、スプレッド \(A_{t-1} – \beta B_{t-1}\) が均衡値 \(\alpha\) より大きくプラスに乖離したとき、\(\gamma_A\) が負の値(例: \(-0.15\))であれば、「次の期に \(A\) の価格が乖離幅の 15% 分だけ下落して均衡に戻ろうとする」というメカニズムが働きます。
この \(\gamma\) の絶対値が大きいほど、「スプレッドの寿命が短く、高頻度で平均回帰を繰り返す=トレード効率が高いなペア」であると判断できます。共和分テストはペアの「質」を保証し、VECMはその「回転率(収益機会の頻度)」を教えてくれるのです。
2. 【実践】Pythonによるペアスクリーニングの可視化
次のステップとして、前節で紹介しました共和分検定の手法を実際に動作するコードで確認していきます。 事例として有力地方銀行である横浜フィナンシャルグループ 7186、ひろぎんホールディングス 7337をピックアップします。
以下のコードは pytho3.10以降の環境を想定しています。必要なモジュール類は事前にインストールしてください。
2.1. 株価データの準備
以下のコードは、指定した銘柄コードをダウンロードしてcsvファイルとして保存します。
import pandas as pd
import yfinance as yf

#code = "7337.T"  # ひろぎんホールディングス
code = "7186.T"  # 横浜フィナンシャルグループ

# Tickerオブジェクトの作成
ticker = yf.Ticker(code)

# 過去6年間の日次データを取得(period='6y', interval='1d')
# 補正前(調整前)の株価を取得するため、auto_adjust=False を指定
df = ticker.history(period="6y", interval="1d", auto_adjust=False)

# index(DatetimeIndex)をカラムとしてリセットし、元のコードと同じ列構成にする
df = df.reset_index()

# 必要な列のみを抽出して並び替え
# yfinanceはデフォルトで 'Date', 'Open', 'High', 'Low', 'Close', 'Volume' などを返します
df = df[['Date', 'Open', 'High', 'Low', 'Close', 'Volume']]

# タイムゾーンを日本標準時(Asia/Tokyo)に変換
df['Date'] = df['Date'].dt.tz_convert('Asia/Tokyo')

# Date列のフォーマットを日付のみに変更する(時分秒をカットする)
df['Date'] = df['Date'].dt.strftime('%Y-%m-%d')

# csv出力。小数点以下は2桁までとする。インデクス(通番)は出力しないようにする
df.to_csv(f"{code}.csv", float_format='%.2f', index=False)
ダウンロードに成功すると以下のフォーマットのcsvが生成されます。
Date,Open,High,Low,Close,Volume
2020-10-02,690.00,700.00,650.00,650.00,1645800
2020-10-05,660.00,663.00,627.00,631.00,773700
2020-10-06,621.00,624.00,603.00,605.00,1001200
2020-10-07,602.00,608.00,584.00,599.00,827200
2020-10-08,603.00,614.00,601.00,609.00,599100
2020-10-09,612.00,617.00,605.00,613.00,328600
...
2.2. 共和分検定を実行する。
2銘柄の株価データを用いて、 共和分関係の有無を統計的に検証し、価格スプレッドとローリング検定結果を可視化します。ペアトレード戦略の前処理として、2銘柄が長期的に均衡関係を持つかどうかを確認することが目的です。
使用ライブラリ
| ライブラリ | 用途 |
|---|---|
| pandas / numpy | データ操作・数値計算 |
| matplotlib + japanize_matplotlib | グラフ描画(日本語フォント対応) |
| statsmodels | ADF検定・Engle-Granger検定・Johansen検定 |
| sklearn.preprocessing | スプレッドの正規化(MinMaxScaler) |
動作フロー
[Step 1] CSVデータ読み込み・前処理
       ↓
[Step 2] 単位根検定(ADF検定)― 各銘柄が非定常かどうかを確認
       ↓
[Step 3] ローリング共和分検定 ― 6ヶ月窓×1ヶ月ステップで時系列的に検証
         ├─ Engle-Granger検定
         └─ Johansen検定
       ↓
[Step 4] WF ローリングOLSによるスプレッド計算(対数株価ベース) ― ヘッジ比率推定 → 対数スプレッド生成
       ↓
[Step 5] 可視化プロット ― 株価推移 + スプレッド + ローリング検定結果を3段グラフで表示
各ステップの詳細
Step 1 — データ読み込み・前処理
stockA = pd.read_csv("7186.T.csv", parse_dates=["Date"], index_col="Date")
stockB = pd.read_csv("7387.T.csv", parse_dates=["Date"], index_col="Date")
combined_data = pd.concat([stockA["Close"], stockB["Close"]], axis=1).dropna()
combined_data.columns = ["stockA", "stockB"]
combined_data = combined_data.asfreq("B").ffill()- 各CSVから終値(Close)のみ抽出し、日付で内部結合
- 欠損値は
dropna()で除去したのち、ビジネスデー(B)頻度に揃えてffill()で前埋め - ローリング窓の長さを営業日数で一定に保つため、頻度を明示的に設定している
- 学習期間とテスト期間の分割は行わず、全期間を分析対象とする
log_data = np.log(combined_data)で対数株価を生成する。以降の統計処理はすべて対数株価を使用し、生株価(combined_data)はPanel 1 の可視化にのみ使用する
Step 2 — 単位根検定(ADF検定)
目的: 各銘柄の対数株価系列が I(1)(1次和分) であることを確認します。
共和分検定はどちらも「原系列は非定常、差分は定常」であることを前提とするため、先にこれを確認します。対数株価は生株価と同様に I(1) であり(対数変換は単調変換のため非定常性を保存する)、以降の共和分検定や弾力性ベースの β 推定との一貫性から、ここでも対数株価(log_data)を使用します。
| 判定 | p値 |
|---|---|
| 単位根あり(非定常) | p > 0.05 |
| 単位根なし(定常) | p ≤ 0.05 |
7186.T ADF 検定統計量: -x.xxxx, p-値: 0.xxxx -> 単位根あり(非定常)
7337.T ADF 検定統計量: -x.xxxx, p-値: 0.xxxx -> 単位根あり(非定常)
株価は価格が漂流する非定常系列であることがほとんどのため、p > 0.05 が期待される結果。
Step 3 — ローリング共和分検定
目的: 2銘柄の共和分関係が 時間的に安定しているか を確認します。
静的(全期間一括)の検定では「どの時期に共和分があったか」がわからないため、窓をスライドさせながら検定を繰り返す。各ウィンドウには対数株価(log_data.iloc[...])を渡します。
パラメータ
| 変数 | 値 | 意味 |
|---|---|---|
window_size | 6 | 窓サイズ(ヶ月) |
step | 1 | スライド幅(ヶ月) |
window_len | 6 × 20 = 120 | 窓サイズ(営業日数) |
step_len | 1 × 20 = 20 | スライド幅(営業日数) |
Engle-Granger検定
_, p_value, _ = coint(window_data["NYK"], window_data["MOL"])
eg_exists = p_value < 0.05- 帰無仮説「共和分関係なし」
- p < 0.05 で棄却 → 共和分あり
- 2変数の場合にシンプルに使える方法(OLS残差のADF検定と等価)
Johansen検定
jo_result = coint_johansen(window_data, det_order=0, k_ar_diff=1)
trace_stat = jo_result.lr1[0]    # トレース統計量(r=0 の検定)
crit_val   = jo_result.cvt[0, 1] # 5% 臨界値(= 15.49)
jo_exists = trace_stat > crit_val- トレース検定(lr1)の r=0行を参照し、「共和分ベクトルが0本」の帰無仮説を検定
- 統計量 > 5%臨界値(15.49)で棄却 →少なくとも1本の共和分ベクトルが存在
LinAlgErrorは窓内でデータが縮退(rank欠落)した場合に発生し、jo_exists=Falseとして処理を継続
結果の保存
各窓の結果は window_results にタプル形式で蓄積される:
window_results.append(
    (window_data.index[0], window_data.index[-1],
     eg_exists, jo_exists, p_value, trace_stat)
)
出力例
期間 2024-01 - 2024-06: EG=あり(p=0.0231)  Johansen=あり(stat=18.45)
期間 2024-02 - 2024-07: EG=なし(p=0.1834)  Johansen=あり(stat=16.02)
------------------------------------------------------------
総ウィンドウ数: 30
共和分検出回数 -> E.G.検定: 18回, Johansen検定: 22回
Step 4 — Walk Forward ローリングOLSによるスプレッド計算(対数株価ベース)
目的:
2銘柄の対数価格差(スプレッド)を定量化し、平均回帰する系列を生成します。 未来データを暗黙に使用するルックアヘッドバイアスを排除するため、各時点で「過去 window_len 日のみ」を使ってパラメータを推定します。
OLS 回帰モデル(対数株価)
\[\log(A) = \alpha + \beta \times \log(B) + \varepsilon\]
ここで傾き β と切片 α を各時点のローリング窓から推定する:
| パラメータ | 推定式 | 解釈 |
|---|---|---|
| β(弾力性) | Cov(log A, log B) / Var(log B)(ローリング) | B が 1% 動いたとき A は何%動くか |
| α(切片) | mean(log A) - β × mean(log B) ローリング) | 各窓での対数価格の均衡水準 |
roll_cov = log_data["stockA"].rolling(window_len).cov(log_data["stockB"])
roll_var = log_data["stockB"].rolling(window_len).var()
beta_wf  = roll_cov / roll_var

alpha_wf = (
    log_data["stockA"].rolling(window_len).mean()
    - beta_wf * log_data["stockB"].rolling(window_len).mean()
)

spread_wf = log_data["stockA"] - beta_wf * log_data["stockB"] - alpha_wf
スプレッドの正規化
valid_mask = spread_wf.notna()
scaler_spread = MinMaxScaler(feature_range=(-1, 1))
_norm = scaler_spread.fit_transform(spread_wf[valid_mask].values.reshape(-1, 1)).flatten()
stationary_series = pd.Series(np.nan, index=combined_data.index)
stationary_series[valid_mask] = _norm- NaN を除いた有効データのみで MinMaxScaler を学習し、[-1, 1]に変換
- グラフ表示上の Y軸スケールを統一するための正規化であり、スプレッドの符号・方向は保持される
Step 5 — 可視化
3段組グラフ(高さ比率 3 : 1.2 : 2)を描画。
| パネル | 内容 |
|---|---|
| 上段 | 2銘柄の生株価(円)推移(参考用)+ ローリング検定成立状況を背景色で表示 |
| 中段 | 対数株価ベースの WFスプレッド(log(A) − β×log(B) − α、ルックアヘッドなし) |
| 下段 | ローリング共和分検定の結果(EG p値 / Johansen統計量) |
上段(Panel 1)の背景色
各ローリング窓の期間が、検定結果に応じて以下の色で塗り分けられる(alpha=0.15):
| 色 | 条件 |
|---|---|
| 薄緑 | EG・Johansen 両方合格 |
| 薄黄 | どちらか一方のみ合格 |
| 薄ピンク | EG・Johansen 両方不合格 |
下段(Panel 3)の構成
- 左軸(青): EG p値のステップライン + 0.05閾値破線 +合格○/不合格×マーカー
- 右軸(オレンジ): Johansen統計量のステップライン +15.49臨界値破線
- 背景色:上段と同じ3色ルールで塗り分け(alpha=0.25)
- タイトル: 総窓数・各検定の合格回数を表示
スプレッドが長期的にゼロ付近を行き来していれば、ペアトレード戦略として有効な組み合わせと判断できます。
分析の読み方(実用的な判断フロー)
① ADF検定で両銘柄が非定常(p > 0.05)
      ↓ YES(共和分検定の前提を満たす)
② ローリング共和分検定で検出割合が高い(例: 60%以上のウィンドウで両検定一致)
      ↓ YES(時系列を通じて関係が安定)
③ スプレッドが平均回帰的に推移している(グラフ中段がゼロ付近を振れる)
      ↓ YES
→ ペアトレード対象として有力
入力ファイル
| ファイル名 | 内容 |
|---|---|
7186.T.csv | 銘柄A 株価CSV(Date, Open, High, Low, Close, Volume 等) |
7337.T.csv | 銘柄B 株価CSV(同形式) |
両ファイルともスクリプトと同ディレクトリに配置してください。
2.3. 結果の評価
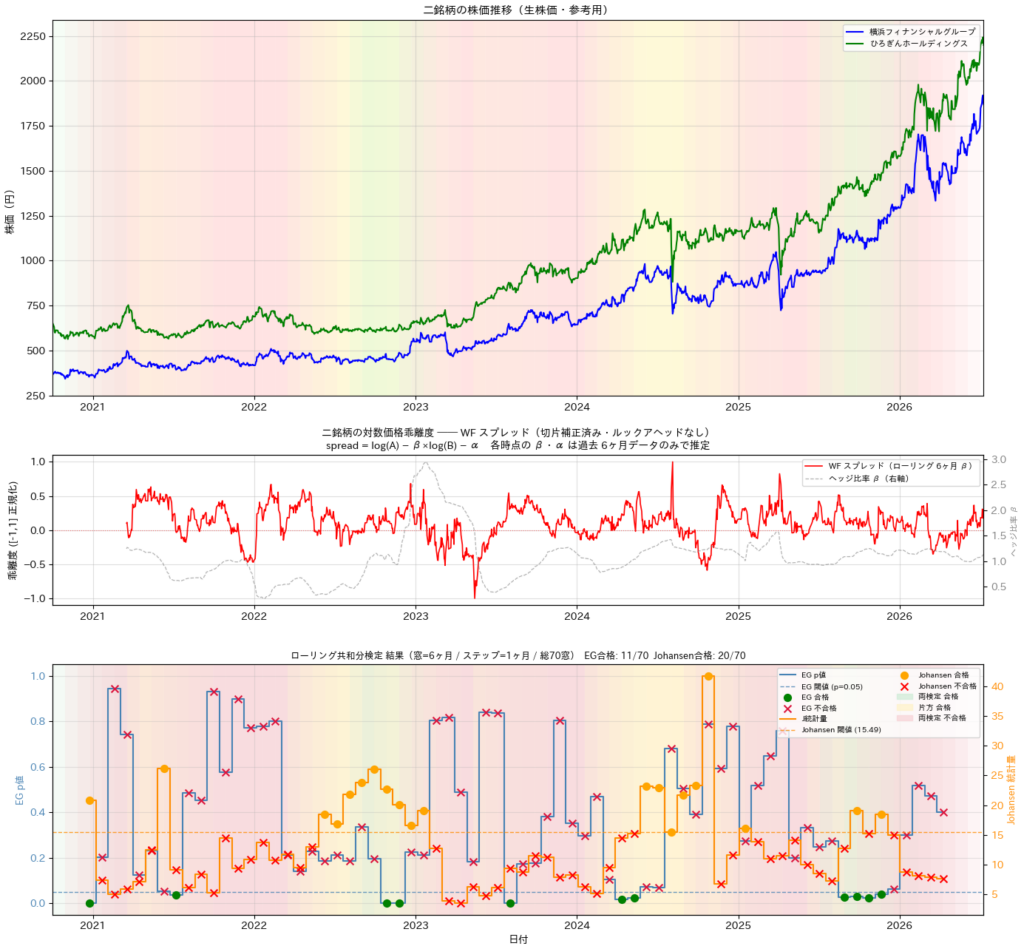
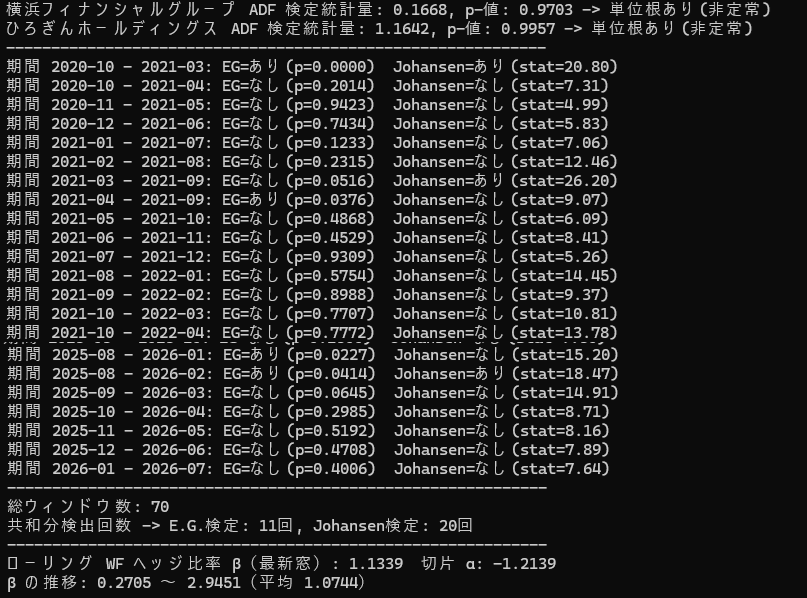
検定結果のコンソール画面から、横浜フィナンシャルグループとひろぎんホールディングスのペアについて重要な統計的特徴が読み取れます。
前提条件のクリア:両銘柄とも「一階和分 I(1)」プロセス
検定結果最上部のADF検定(単位根検定)の結果を見ると、双方ともp値が 0.05 を大きく上回っています(横浜フィナンシャルグループ: 0.9987、ひろぎんホールディングス: 0.9991)。
両銘柄の生価格はどちらも「単位根あり(非定常)」です。これは「株価そのものはランダムウォークしている」ということを意味し、共和分検定を行うための大前提を満たしています。
共和分関係の評価:長期的にはあるが、短期的には崩れやすい
総ウィンドウ数
70回(6か月ごとのローリング検定)のうち、共和分が検出された回数は以下の通りです。
- Engle-Granger(E.G.)検定: 10回 / 70ウィンドウ
- Johansen検定: 20 回 / 70ウィンドウ
【統計的な解釈】
いずれの検定方法でも共和分性が出現する期間は少ないですが、重要なポイントは三段目のプロットの背景色の移り変わりが示すように共和分性の出現と崩壊を観測年間にわたって繰り返していることです。
Johansen検定の方が多く検出されている理由:
Johansen検定は複数変数の同時決定システム(VAR)をベースにしているため、E.G.検定よりも一般に検出力が高い(共和分を見つけやすい)傾向があります。
3. 消えては現れる平均回帰の波に乗る
東証上場企業を網羅的に調べてみると、今回試したペアのように、共和分性は消滅・発現を繰り返す様子をごく普通に見かけます。むしろ実際の金融市場(特に個別株)において「全期間で崩れない共和分関係」が維持されるペアはほぼ存在しないのではないでしょうか。ただしだからといって稀な事象というわけでもなく、「繋がっては離れ、また繋がる」という動的な(Time-varying)パターンが繰り返される類の事象のように見えます。
もし共和分が「永久に続く」のであれば、スプレッドは狭い範囲から一生動きません。ペアトレードの収益の源泉は「一時的に共和分関係が歪んで、スプレッドが大きく拡大すること」そのものです。「多くの期間で共和分が消えている」のは、市場が新しい情報(決算、需給、セクター内の物色対象の変化)を織り込むために、一時的に非平衡状態になっているからです。銀行株のように根底にあるビジネスモデルが極めて類似している場合、行き過ぎた乖離は最終的に経済・金融の仕組みによりスプレッドが平均値へと押し戻される力が働いているのではないかと想像しています。
この観察が、連載次回の主要なテーマになります。伸びては縮むスプレッドの波をうまくとらえることで、利益を見込めるペアトレードの取引構造をつくることができるのか、ポイントはリスク管理です。安定的な共和分性を見込むことが簡単でないならば、当然取引の失敗リスクは上昇します。そこで重要になるのは「危険そうな」スプレッドを事前に見極め、実際に評価損が出たら早期にロスカットする管理機能を発動させることです。過去に遡って株価データを使ったシミュレーションを実行することで想定したリスクマネジメントが有効に機能するか評価してみようと思います。
4. まとめと次回予告
今回のまとめ:数理(共和分)フィルターによって、直感ではなく統計的有意性に基づいたペア選定が可能になった。
次回:ペアトレードの数理と実践:第 4 回 仮想取引バックテスト
5. コード
最後に今回作成したコードを掲載します。データcsvと同じディレクトリに以下のコードをおき、pythonコマンドの引数として実行してください。後の引用の都合上
ファイル名は tsa_coint_2stocks.pyとしておきます。
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import matplotlib.patches as mpatches
from statsmodels.tsa.stattools import adfuller, coint
from statsmodels.tsa.vector_ar.vecm import coint_johansen
import japanize_matplotlib
from sklearn.preprocessing import MinMaxScaler
from numpy.linalg import LinAlgError

# --- 1. データの読み込み---
stockA = pd.read_csv("7186.T.csv", parse_dates=["Date"], index_col="Date")
stockB = pd.read_csv("7337.T.csv", parse_dates=["Date"], index_col="Date")
nameA = "横浜フィナンシャルグループ"
nameB = "ひろぎんホールディングス"
# 終値のみを使用し、結合と欠損値処理(全期間を学習期間とする)
combined_data = pd.concat([stockA["Close"], stockB["Close"]], axis=1).dropna()
combined_data.columns = ["stockA", "stockB"]
combined_data = combined_data.asfreq("B").ffill()

# 対数株価(統計処理の基本系列)— 可視化のみ生株価を使用
log_data = np.log(combined_data)

# --- 2. 単位根検定(ADF検定)--- ※対数株価で実施
adf_stockA = adfuller(log_data["stockA"])
adf_stockB = adfuller(log_data["stockB"])
print(
    f"{nameA} ADF 検定統計量: {adf_stockA[0]:.4f}, p-値: {adf_stockA[1]:.4f} -> "
    f"{'単位根あり(非定常)' if adf_stockA[1] > 0.05 else '単位根なし(定常)'}"
)
print(
    f"{nameB} ADF 検定統計量: {adf_stockB[0]:.4f}, p-値: {adf_stockB[1]:.4f} -> "
    f"{'単位根あり(非定常)' if adf_stockB[1] > 0.05 else '単位根なし(定常)'}"
)
print("-" * 60)

# --- 3. ローリング(ウィンドウ)共和分検定 ---
window_size = 6  # 6か月
step = 1  # 1か月
window_len = window_size * 20
step_len = step * 20

JOHANSEN_CRIT = 15.49  # Johansen 5% 臨界値

count_coint_eg = 0
count_coint_jo = 0
window_results = []  # (start, end, eg_exists, jo_exists, p_value, trace_stat)

for i in range(0, len(log_data) - window_len + 1, step_len):
    window_data = log_data.iloc[i : i + window_len]  # 対数株価ウィンドウ

    # Engle-Granger検定(対数株価)
    _, p_value, _ = coint(window_data["stockA"], window_data["stockB"])
    eg_exists = p_value < 0.05
    if eg_exists:
        count_coint_eg += 1

    # Johansen検定(対数株価)
    trace_stat = np.nan
    try:
        jo_result = coint_johansen(window_data, det_order=0, k_ar_diff=1)
        trace_stat = jo_result.lr1[0]
        crit_val = jo_result.cvt[0, 1]
        jo_exists = trace_stat > crit_val
        if jo_exists:
            count_coint_jo += 1
    except LinAlgError as e:
        jo_exists = False
        print(f"エラー: {e} - ウィンドウ: {window_data.index[0].strftime('%Y-%m')}")

    window_results.append(
        (
            window_data.index[0],
            window_data.index[-1],
            eg_exists,
            jo_exists,
            p_value,
            trace_stat,
        )
    )

    print(
        f"期間 {window_data.index[0].strftime('%Y-%m')} - {window_data.index[-1].strftime('%Y-%m')}: "
        f"EG={'あり' if eg_exists else 'なし'}(p={p_value:.4f})  "
        f"Johansen={'あり' if jo_exists else 'なし'}"
        f"({'N/A' if np.isnan(trace_stat) else f'stat={trace_stat:.2f}'})"
    )

print("-" * 60)
print(f"総ウィンドウ数: {len(window_results)}")
print(
    f"共和分検出回数 -> E.G.検定: {count_coint_eg}回, Johansen検定: {count_coint_jo}回"
)
print("-" * 60)

# --- 4. WF(ローリング)スプレッド計算(Panel 2 表示用) ---
# 対数株価を使用: spread = log(A) - β×log(B) - α
# β = Cov(log A, log B) / Var(log B) で弾力性(elasticity)として推定する
# 先頭 window_len-1 点は NaN となる
roll_cov = log_data["stockA"].rolling(window_len).cov(log_data["stockB"])
roll_var = log_data["stockB"].rolling(window_len).var()
beta_wf  = roll_cov / roll_var                                     # 時変ヘッジ比率(弾力性)
# 切片 α = mean(log A) - β × mean(log B) を各窓で計算し、残差のみを取り出す
alpha_wf = (
    log_data["stockA"].rolling(window_len).mean()
    - beta_wf * log_data["stockB"].rolling(window_len).mean()
)
spread_wf = log_data["stockA"] - beta_wf * log_data["stockB"] - alpha_wf

# 正規化: NaN を除いた有効データで MinMaxScaler を学習し、全インデックスに適用
valid_mask = spread_wf.notna()
scaler_spread = MinMaxScaler(feature_range=(-1, 1))
_norm = scaler_spread.fit_transform(spread_wf[valid_mask].values.reshape(-1, 1)).flatten()
stationary_series = pd.Series(np.nan, index=combined_data.index)
stationary_series[valid_mask] = _norm

print(f"ローリング WF ヘッジ比率 β(最新窓): {beta_wf.iloc[-1]:.4f}  切片 α: {alpha_wf.iloc[-1]:.4f}")
print(f"β の推移: {beta_wf.min():.4f} 〜 {beta_wf.max():.4f}(平均 {beta_wf.mean():.4f})")

# ================================================================
# ローリング窓データの準備(Panel 3 用)
# ================================================================
win_starts = np.array([r[0] for r in window_results])
win_ends = np.array([r[1] for r in window_results])
win_mids = np.array([r[0] + (r[1] - r[0]) / 2 for r in window_results])
eg_passes = np.array([r[2] for r in window_results])
jo_passes = np.array([r[3] for r in window_results])
eg_pvals = np.array([r[4] for r in window_results], dtype=float)
jo_traces = np.array([r[5] for r in window_results], dtype=float)

# --- 4. 可視化プロット ---
fig, axs = plt.subplots(
    3,
    1,
    figsize=(14, 13),
    gridspec_kw={"height_ratios": [3, 1.2, 2]},
)

# ================================================================
# Panel 1: 生価格
# ================================================================
ax1 = axs[0]
ax1.plot(
    combined_data.index,
    combined_data["stockA"],
    label=nameA,
    color="blue",
)
ax1.plot(
    combined_data.index,
    combined_data["stockB"],
    label=nameB,
    color="green",
)

# 各ローリング窓の共和分成立状況を背景に薄く着色
for start, end, eg, jo, *_ in window_results:
    if eg and jo:
        bg = "#c8f7c5"  # 薄緑: 両検定合格
    elif eg or jo:
        bg = "#fef9c3"  # 薄黄: 片方合格
    else:
        bg = "#ffd6d6"  # 薄ピンク: 両検定不合格
    ax1.axvspan(start, end, alpha=0.15, color=bg, lw=0)

ax1.set_title("二銘柄の株価推移(生株価・参考用)", fontsize=11)
ax1.set_ylabel("株価(円)")
ax1.legend(fontsize=8)
ax1.grid(True, alpha=0.4)

# ================================================================
# Panel 2: WF スプレッド(ルックアヘッドなし)
# ================================================================
ax2 = axs[1]
ax2r = ax2.twinx()  # 右軸: ローリングヘッジ比率 β

# 左軸: 正規化スプレッド(赤)
ax2.plot(
    combined_data.index,
    stationary_series,
    label=f"WF スプレッド(ローリング {window_size}ヶ月 β)",
    color="red",
    lw=1.2,
    zorder=3,
)
ax2.axhline(0, color="red", linestyle=":", lw=0.8, alpha=0.5)

# 右軸: ローリングβ(灰色破線)— βの時変性を確認するための補助情報
ax2r.plot(
    combined_data.index,
    beta_wf,
    label="ヘッジ比率 β(右軸)",
    color="gray",
    lw=0.9,
    linestyle="--",
    alpha=0.6,
    zorder=2,
)
ax2r.set_ylabel("ヘッジ比率 β", color="gray", fontsize=8)
ax2r.tick_params(axis="y", labelcolor="gray")

ax2.set_title(
    f"二銘柄の対数価格乖離度 ── WF スプレッド(切片補正済み・ルックアヘッドなし)\n"
    f"spread = log(A) − β×log(B) − α 各時点の β・α は過去 {window_size}ヶ月データのみで推定",
    fontsize=10,
)
ax2.set_ylabel("乖離度 ([-1,1] 正規化)")
lines_l, labels_l = ax2.get_legend_handles_labels()
lines_r, labels_r = ax2r.get_legend_handles_labels()
ax2.legend(lines_l + lines_r, labels_l + labels_r, fontsize=8)
ax2.grid(True, alpha=0.4)

# ================================================================
# Panel 3 (NEW): ローリング共和分検定結果
# ================================================================
ax3 = axs[2]
ax3r = ax3.twinx()  # 右軸: Johansen 統計量

# 背景色: 両検定の合否組み合わせ
for i in range(len(win_mids)):
    eg, jo = eg_passes[i], jo_passes[i]
    if eg and jo:
        bg = "#d4edda"
    elif eg or jo:
        bg = "#fff3cd"
    else:
        bg = "#f8d7da"
    ax3.axvspan(win_starts[i], win_ends[i], alpha=0.25, color=bg, lw=0, zorder=1)

# EG p値 (左軸, 青)
ax3.step(
    win_mids, eg_pvals, where="mid", color="steelblue", lw=1.5, label="EG p値", zorder=3
)
ax3.axhline(
    0.05, color="steelblue", linestyle="--", lw=1, alpha=0.8, label="EG 閾値 (p=0.05)"
)
ax3.scatter(
    win_mids[eg_passes],
    eg_pvals[eg_passes],
    color="green",
    s=50,
    zorder=5,
    marker="o",
    label="EG 合格",
)
ax3.scatter(
    win_mids[~eg_passes],
    eg_pvals[~eg_passes],
    color="crimson",
    s=50,
    zorder=5,
    marker="x",
    label="EG 不合格",
)
ax3.set_ylabel("EG p値", color="steelblue", fontsize=9)
ax3.tick_params(axis="y", labelcolor="steelblue")
ax3.set_ylim(-0.05, 1.05)

# Johansen 統計量 (右軸, オレンジ)
valid = ~np.isnan(jo_traces)
ax3r.step(
    win_mids[valid],
    jo_traces[valid],
    where="mid",
    color="darkorange",
    lw=1.5,
    label="J統計量",
    zorder=3,
)
ax3r.axhline(
    JOHANSEN_CRIT,
    color="darkorange",
    linestyle="--",
    lw=1,
    alpha=0.8,
    label=f"Johansen 閾値 ({JOHANSEN_CRIT})",
)
ax3r.scatter(
    win_mids[jo_passes & valid],
    jo_traces[jo_passes & valid],
    color="orange",
    s=50,
    zorder=5,
    marker="o",
    label="Johansen 合格",
)
ax3r.scatter(
    win_mids[~jo_passes & valid],
    jo_traces[~jo_passes & valid],
    color="red",
    s=50,
    zorder=5,
    marker="x",
    label="Johansen 不合格",
)
ax3r.set_ylabel("Johansen 統計量", color="darkorange", fontsize=9)
ax3r.tick_params(axis="y", labelcolor="darkorange")

# 凡例の統合
lines_l, labels_l = ax3.get_legend_handles_labels()
lines_r, labels_r = ax3r.get_legend_handles_labels()
patch_both = mpatches.Patch(color="#d4edda", alpha=0.8, label="両検定 合格")
patch_one = mpatches.Patch(color="#fff3cd", alpha=0.8, label="片方 合格")
patch_none = mpatches.Patch(color="#f8d7da", alpha=0.8, label="両検定 不合格")
ax3.legend(
    handles=lines_l + lines_r + [patch_both, patch_one, patch_none],
    labels=labels_l + labels_r + ["両検定 合格", "片方 合格", "両検定 不合格"],
    loc="upper right",
    fontsize=7.5,
    ncol=2,
)

ax3.set_title(
    f"ローリング共和分検定 結果(窓={window_size}ヶ月 / ステップ={step}ヶ月 / "
    f"総{len(window_results)}窓)  "
    f"EG合格: {count_coint_eg}/{len(window_results)}  "
    f"Johansen合格: {count_coint_jo}/{len(window_results)}",
    fontsize=9,
)
ax3.set_xlabel("日付")
ax3.grid(True, alpha=0.3)

# 表示期間: 全ウィンドウが含まれるようデータ全期間に設定
start_plot_date = combined_data.index[0]
end_plot_date = combined_data.index[-1]
for ax in axs:
    ax.set_xlim(start_plot_date, end_plot_date)
ax2r.set_xlim(start_plot_date, end_plot_date)
ax3r.set_xlim(start_plot_date, end_plot_date)

plt.tight_layout(h_pad=1.5)
plt.show()